首届算博会ODX见闻:高速互连、液冷、800V、NPO等产业趋势动态跟踪
题材
(无 plates 标注,见下方观点单元)个股
立讯精密 麦格米特 晶丰明源观点单元(正文分节)
- 第0节首届算博会ODX见闻:高速互连、液冷、800V、NPO等产业趋势动态跟踪立讯精密 麦格米特 晶丰明源
【本文来自持牌证券机构,不代表平台观点,请独立判断和决策】
招商证券电子团队近日参加了在北京举办的ODX2026大会,大会上AI上下游产业链各公司专家做了非常详细的主题演讲,大会对当前AI产业发展现状深刻剖析,各论坛板块探讨火热,招商证券电子团队整理了本次大会部分演讲的核心观点,供投资者参考。
整体产业趋势来看,生成式AI走向AgenticAI,单Agent走向多Agent协同等,这些变化将依次重写算力类型、访存模式、通信拓扑、存储层级、CPU/GPU配比和功耗曲线。
GPU仍是算力核心,但新增价值量越来越多地流向CPU调度、HBM/DRAM/SSD多级内存、ScaleUp网络、KVCache服务、800V供电、液冷以及整机柜系统工程。行业评价标准更关注Token/s、Token/W、单用户Token/s、TTFT、资源利用率及单Token成本等。
1)超节点与散热
液冷与800V、高速互连和机柜结构协同设计,整机价值要以Token/s等衡量。
MoE、PD分离、长上下文和训推一体要求更大的ScaleUp域,同时单芯片功耗持续提升,使传统8卡服务器、风冷机柜及按部件独立设计的模式同时失效。超节点因此演进为以机柜为最小交付单元,将CPU/GPU/XPU、内存和存储池、交换芯片、CableTray/正交背板、供电母线、液冷管路及管理单元统一设计。
关于超节点架构,行业正朝着由模块化、三总线盲插和全液冷提升单柜密度及可维护性;更长期则与800VHVDC、NPO/CPO、全光互连及算电协同共同重构机柜几何形态。整机价值最终要以有效GPU卡时、Token/s、Token/W及可用率衡量,而非单纯比较理论峰值算力。
相关公司动态如下:
超聚变:从2017年三总线液冷整机柜出发,已完成核心部件自研和百万级XPU规模商用,并把下一代目标推向672GPU、1MW供电/制冷和全光互连;
百度:一条线做计算节点模块化,另一条线推进天池1.0→3.0整柜演进,并已积累万卡级国产集群交付与运维数据;
新华三:以UXM标准化解决异构XPU整机碎片化,同时探索正压与负压两条液冷路线。UXM把类PCIe、BFX和OAM三类模组纳入共同体系,统一54V供电、机械、液冷和高速接口,并允许不同ScaleUp协议、正交或分布式整机架构并行。面对单芯片2kW并向5kW演进、交换芯片功耗超过3.5kW,公司同步推进800VPowerShelf、VPD和液冷方案。
2)网络与互连:光铜并进,业界对NPO重视度有所提高
当前互连行业呈现多轨并行、双轨并进的发展方向,Scaleup、Scaleout与Scaleacross同步扩容,以实现更高算力密度,互连的方式也从传统的GPU-GPU通信扩展为GPU-CPU-内存-SSD的全系统互连。
互连方案上,依旧遵循“能用铜就用铜,必须用光再用光”的原则,产业趋势呈现出光铜并进的格局。Scaleup作为智算互联中带宽压力最大的互连架构,目前含有铜、光两种技术路径,但随着互连规模的扩大,单机柜面临物理承载极限,因此需要跨机柜互连,进一步催生光互连需求。
铜互连方面,随着传输速率的持续提升,为降低损耗同时延长铜缆生命周期,从传统的CableCartridge铜线缆方案进一步延伸出NPC以及最终的CPC方案。
光互连方面,观察到业界普遍对NPO的重视程度提高,尽管其并非最终技术演进路线,但却是在兼顾技术落地进度、性能、功耗以及可维护性下的阶段性最优解。
具体应用上,立讯技术(立讯精密控股子公司)遵循光铜并进的发展思路,在224G速率下具备完整的互联解决方案,覆盖从GPU到交换芯片、从板内到板间、从柜内到柜间的完整端到端链路,包括高速连接器、线缆组件、NPO/CPO连光板组件,同时配套散热、电源方案等。
同时立讯已在开展448G速率完整方案预研,CPC方案实物样品已经产出,完全满足PAM6要求,PAM4还会迭代新版本,预计今年内可以推出。
腾讯与阿里在光互连领域联合发起UPO标准制定,产业链上下游大量合作伙伴共同参与,共三种形态适配不同应用场景,与主芯片集成可采用多种集成方案,UPO标准采用LGASocket连接方案,实测指标可满足224G应用需求,也可平滑演进至448G。
当前UPO标准制定速度加快,预计年底推出Type1XDSocket产品,明年启动448GUPO标准制定。
3)存储:KVCache带来存储容量与传输两大难题
KVCache逐步成为推理场景新瓶颈,随着上下文长度、并发数量提升,KVCache占用容量会快速扩张,给推理系统带来压力。针对KVCache,除了解决存储容量,还需要解决传输速度、数据复用两大问题,当缓存利用率超过95%时,系统会从计算密集型转变为I/O密集型,KVCache传输瓶颈会凸显。
因此,如何合理有效的管理KVCache对于推理工作负载至关重要,内存层级架构的精细分工与紧密互连重要性凸显。当前内存层级主要包含L1-GPUHBM→L2-CPUDRAM→L-本地SSD→L3.5-ICMS池→L4云存储,针对L1与L2之间的传输GAP。
腾讯:提出L1.5解决方案,在现有超节点架构中接入独立内存池,直接在ScaleupSwitch接入专用DDR内存池,可为单颗GPU提供约500GB访问容量以及400-800GB/s访问带宽,可显著提高batchsize,带动TPS提升,大幅提高模型性能。腾讯推出的MemorySwitchFabric项目顺利开展,支持DRAM、NAND、HBF,9月启动软件层开发,明年会有MemoryConnect芯片,将原Scaleup网络从算力互连演进为内存互连。
三星:针对L1.5层级,三星推出zNAND-O,采用SLC架构,与NPU合封,推出适配端侧与服务器端架构,极大程度提高整体运行性能,预计2028年起深度赋能AI创新。
4)电源:800VDC为兆瓦级机柜升级的物理必然
GPU单芯片功耗由数百瓦走向3.6-5kW、单柜功率由数十kW走向300-600kW乃至1MW后,供电系统需要同时完成四项重构:一是以800VHVDC降低长距离输电电流和铜损;二是把DC/DC、VRM持续推近负载,解决芯片“最后一英寸”的数千安培供电;三是通过超级电容、BBU/储能、分层控制消化GPU毫秒级动态功率;四是把供电与算力调度、液冷、电网和微电网统一设计。
当前主线仍是先以800V→50/54V兼容既有服务器生态,再逐步演进至12V/6V中间母线、800V进板、VPD/IVR;更长期则由SST推动中压直连和原生直流。电源由服务器配套部件升级为贯穿“源-网-荷-储-芯”的机架级能源平台。
麦格米特:把Sidecar定义为可扩展、可管理的机架级能源平台。公司将数据中心电源分为Shelf内分布式、机架内集中式和机架级能源平台三类;
晶丰明源:聚焦“最后一英寸”,以6V母线、TLVR、Co-PackLDMOS和VPD解决4000A级Vcore供电。
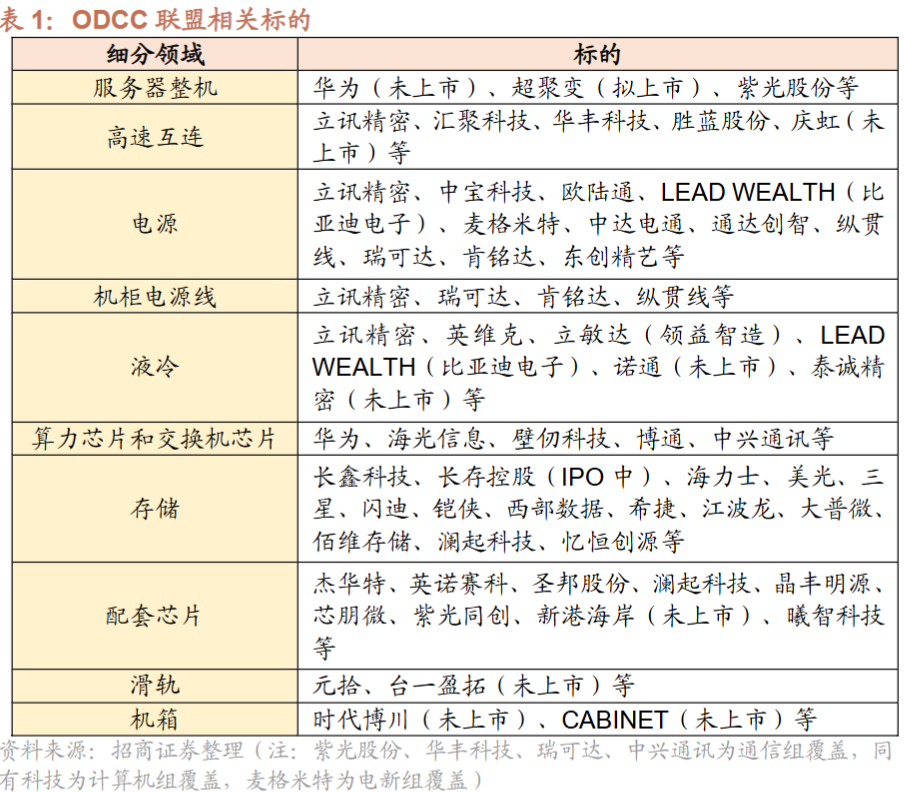
整体来看,AI产业链基础设施持续升级,关注服务器整机、高速互连、电源、机柜电源线、液冷、算力芯片和交换芯片、存储、配套芯片、滑轨、机箱等细分领域公司。
研报来源:招商证券,鄢凡,S1090511060002,从大模型演进到Token工厂,AI产业链共筑基础设施升级——ODX 2026首届算博会跟踪报告。2026年9月8日